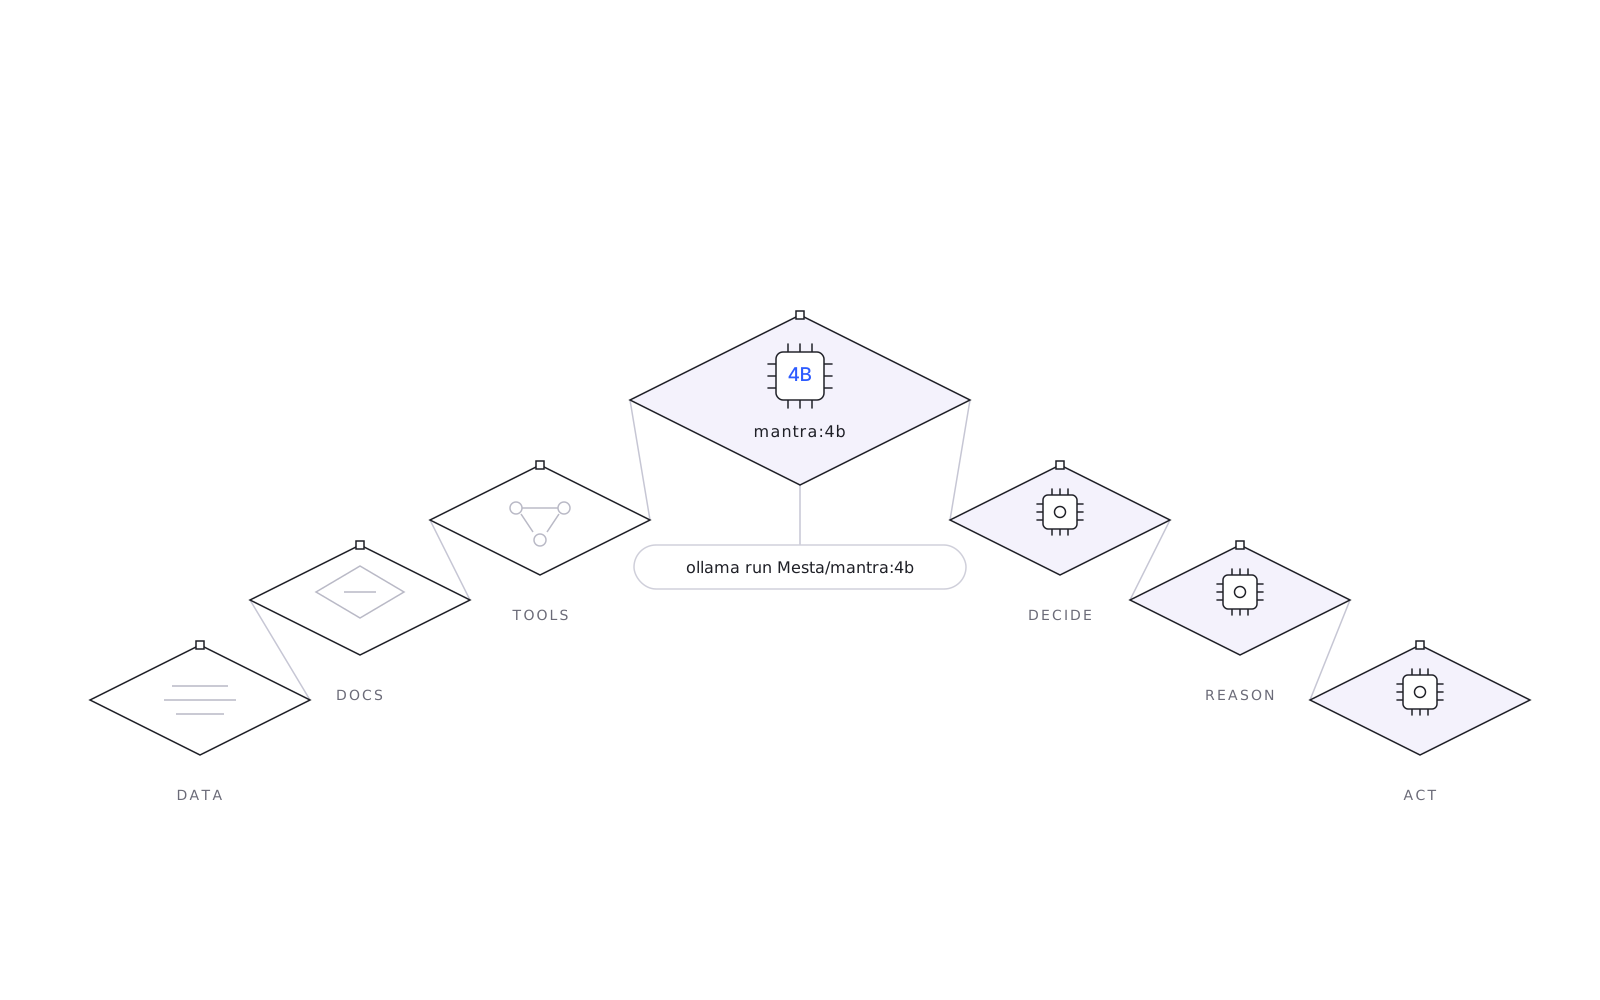
Sebagian besar riset model penalaran mengandaikan pusat data. Kami berangkat dari pertanyaan lain: apa yang dibutuhkan agar seseorang atau sebuah perusahaan benar-benar memiliki model yang mengambil keputusan atas nama mereka? Memiliki berarti model itu berjalan di perangkat sendiri, tidak mengirim data ke luar, bisa dilatih ulang dengan data sendiri, dan meninggalkan jejak yang bisa diperiksa kemudian.
Syarat itu menentukan ukurannya. Model yang Anda miliki harus muat di perangkat biasa: model 2B kami dilatih di laptop 16 GB, dan mantra:4b berjalan dari unduhan 2,7 GB. Syarat itu juga menaikkan standar kepercayaan. Ketika model bertindak untuk pemiliknya, halusinasi bukan sekadar jawaban yang salah. Halusinasi menjadi catatan yang salah: relasi yang tidak didukung bukti, atau fakta tercatat yang dibatalkan tanpa diperiksa.
Tiga mode dalam satu model
Sebelum menjawab, mantra:4b menulis header singkat yang menyebut mode dan seberapa besar usaha (effort) yang akan dipakai:
- Decide: memilih tepat satu opsi dari daftar tertutup dan memberi alasan dalam satu kalimat.
- Reason: mengerjakan soal langkah demi langkah sampai ke nilai akhir.
- Act: memilih tindakan berikutnya dalam tugas multi-langkah, termasuk pemanggilan tool terstruktur.
Model ini memahami bahasa Inggris dan Indonesia, dan berjalan pada temperature 0, sehingga input yang sama selalu menghasilkan output yang sama.
Keputusan yang bisa diperiksa kemudian
Mantra tidak mengarang opsinya sendiri. Generator deterministik membaca bukti dan menyusun daftar pilihan yang sah, ditambah no_op dan abstain, lalu mengacaknya agar huruf jawaban yang benar tidak bisa ditebak dari posisinya. Model kemudian wajib mengikuti protokol:
- Berpikir di dalam jejak penalaran yang dibatasi.
- Memanggil tool pembaca status sebelum membatalkan fakta yang sudah tercatat.
- Menutup dengan satu huruf jawaban dan alasan satu kalimat.
Parser yang ketat menganggap setiap balasan yang tidak menyebut tepat satu opsi dari daftar sebagai abstain. Bukti dan output tool diperlakukan sebagai data, tidak pernah sebagai perintah. Setiap keputusan disimpan beserta alasannya di log replay. Pada set uji held-out kami, tidak ada jejak yang menolak sebuah petunjuk sementara jawabannya justru menyetujuinya, sehingga setiap jawaban salah terlihat sebagai pemeriksaan yang terlewat di jejaknya.
Berpikir panjang hanya bila perlu
Model penalaran besar menghabiskan rantai pikir yang sama panjangnya untuk soal mudah maupun sulit. Mantra punya tiga tingkat usaha, dan kami membangunnya dengan memangkas jejak penalaran yang sudah terverifikasi, bukan membuat jejak baru: high menyimpan jejak penuh, medium menyimpan baris-baris terakhirnya, low menghapusnya. Pemanggilan tool tetap ada di setiap tingkat, jadi pemeriksaan sebelum pembatalan tidak pernah bergantung pada tingkat usaha.
Pada model 2B, usaha medium mempertahankan akurasi 0,937 dibanding 0,951 pada usaha high, dengan teks penalaran 23% lebih sedikit. Supaya model bisa memilih tingkat usahanya sendiri, kami melabeli setiap jenis input dengan tingkat termurah yang memenuhi anggaran komputasi, memakai oracle Lagrangian atas hasil yang diukur. Dengan label itu, model berpikir lebih panjang pada jenis input yang sulit (keputusan gabungan, obrolan, bukti yang ragu-ragu), tetap di usaha low pada yang mudah, dan mencapai 0,979 pada keputusan.
Hasil
Angka berikut untuk build produksi, yaitu Qwen3.5-4B yang di-fine-tune dengan LoRA dan dikuantisasi ke 4 bit:
| Benchmark | mantra:4b |
|---|---|
| Keputusan opsi tertutup (held-out) | 99,5% |
| Prediksi tindakan web berikutnya (Mind2Web) | 94,7% |
| Skenario tool enterprise (88) | 90,9% |
| Soal cerita matematika (GSM8K) | 79,0% |
| Pertanyaan atas 1.888 laporan WARN Act asli, dengan tool pencarian | 67,5% (model dasar: 18,0%) |
| Tingkat pembajakan prompt injection langsung (garak) | 12–34% (sebelum diperkuat: 64–91%) |
Uji atas data asli memperlihatkan apa yang diubah oleh fine-tuning. Diberi tool yang sama, model dasar tidak pernah memanggilnya. Model itu menulis seolah-olah sudah memeriksa data, lalu menebak. Mantra memanggil tool di setiap pertanyaan.
Yang belum bisa dilakukannya
Model yang layak dipercaya harus jujur soal batasannya. Ini batasan kami:
- Kemampuan generalisasinya masih terbatas. Angka 99,5% berasal dari set uji yang mirip dengan data latih. Pada benchmark eksternal typed-decisions, build 4B hanya 3–8 poin di atas baseline yang mengabaikan input, dan hasilnya bervariasi sekitar ±5 poin antar-seed pelatihan.
- Model ini masih bisa dibajak. Perintah yang disisipkan di pesan atau dokumen pengguna masih berhasil pada 12–34% percobaan langsung. Pemilik sebaiknya tidak menaruh rahasia di system prompt.
- Kadang menjawab hal yang tidak bisa dipastikan dari data. Dari 51 pertanyaan nyata yang tidak bisa dijawab oleh datanya, model tetap memilih jawaban spesifik sebanyak 16 kali. Penghitungan lintas banyak baris dan aritmetika tanggal adalah titik lemah yang lebih tepat diserahkan ke tool.
- Bahasa Indonesia masih tertinggal dari bahasa Inggris. Build produksi belum konsisten mematuhi aturan "selalu balas dalam bahasa Indonesia". Build berikutnya sudah bisa, tetapi lebih mudah dibajak.
- Model ini tidak dilatih untuk kode, dan skor keyakinannya, bahkan setelah temperature scaling, masih kurang terkalibrasi dibanding baseline.
Langkah berikutnya
Build berikutnya menargetkan ketahanan injection build produksi tetap terjaga, kepatuhan aturan dari build yang lebih baru ditambahkan tanpa mengorbankan penalaran, dan lebih sedikit jawaban karangan saat data tidak lengkap, dengan aritmetika diserahkan ke tool Python yang terisolasi. Untuk kedaulatan model, tiga hal didahulukan: menutup kesenjangan antara bahasa Indonesia dan Inggris, satu perintah untuk melakukan fine-tuning Mantra dengan data dan perangkat milik pemilik sendiri, dan anggaran komputasi yang menyesuaikan dengan memori perangkat.
Coba sekarang
ollama run Mesta/mantra:4b4,21 miliar parameter, kuantisasi Q4_K_M (2,7 GB), konteks 4.096 token, lisensi Apache-2.0, dibangun di atas Qwen3.5-4B.
Makalah lengkapnya, Closed-Option Decisions and Trimmed-Trace Effort Control in 2B–4B Language Models, membahas metode, interval kepercayaan, dan hasil negatif. Untuk meminta salinan, kirim email ke admin@tantira.id.